
- DOI:
10.13738/j.cnki.acc.qklw60536
- 专辑:
科学Ⅰ辑;信息科技
- 专题:
信息、科学;综合科技
- 分类号:
G90;N92
摘要 目的:建立并验证基于机器学习方法的危重症急性肾损伤患者可解释死亡预测模型。
方法
本研究提取了美国大型公开重症数据库MIMIC-Ⅳ的 2008 年至 2019 年、急性肾损伤(AKI)患者诊断AKI当天的临床数据,随机将数据分为训练队列和验证队列。提取了MIMIC-Ⅲ数据库3005例AKI患者数据作为外部验证集。通过多轮特征选择(低方差过滤、高相关性过滤、互信息筛选、SHAP值分析和递归特征消除)选择出12个最佳特征组合,10 种机器学习方法被用来开发评估住院死亡率的模型。根据其曲线下面积(AUC)选择最优模型。采用SHapley Additive exPlanation (SHAP)值来解释最优模型。
结果
本研究共计急性肾损伤 3701例最终纳入患者(中位年龄,65 岁, 女性 41.3%)。他们被随机分为一个培训队列(2591 人,70%)和一 个验证队列( 1110 人,30%)。10个机器学习模型中随机森林(RF)模型具有最好的判别能力,并采用SHAP方法解释了模型。最终的模型在内部(AUC = 0.807)和外部(AUC =0.720 )验证中都能较准确预测AKI,将有助于临床医生判断重症监护病房ICU 住院患者的预后,并进行早期干预。
关键词:重症患者;急性肾损伤;机器学习;预后预测模型;SHAP。
介绍
在ICU中,AKI的发病率和死亡率都处于较高水平[1–3]。这不仅严重影响患者的健康,还带来了沉重的经济负担,而目前医学界尚未找到有效的根治方法[4]。危重症AKI的死亡机制十分复杂,涉及多种因素相互交织。因此,构建一个包含多个相关风险因素的预测模型,或许能为解决这一难题提供更有效的途径。MIMIC Ⅳ数据库6万多名患者的临床数据,在医疗大数据中,机器学习方法可以更方便地处理自变量的多重共线性,可以提高预后预测模型的预测辨别力[5,6] 。在医学领域,机器学习技术如随机森林和梯度提升机已被广泛应用[7,8]。本研究的最佳模型随机森林算法,为重症AKI患者构建了一个具有可解释性的死亡风险预测模型。通过SHAP方法,不仅提供了对整体功能的全局解释,还详细阐述了如何利用个性化输入数据对重症AKI患者进行特定预测的局部解释。最终模型在内部和外部验证中均展现出良好的性能,能够助力临床医生早期识别高危AKI患者并及时进行干预。
1 资料与方法
1.1 一般资料
MIMIC数据库对患者信息进行了脱敏处理。在获得人类研究参与者保护评估(证书编号55810423)的授权后,我们使用结构化查询语言(SQL)从该数据库中提取数据。主要研究终点为住院死亡率,数据被分为训练队列和验证队列,比例7:3。
急性肾损伤(AKI)的诊断标准依据改善全球肾脏病预后组织(KDIGO)的标准确定,包括:在48小时内血清肌酐增加0.3 mg/dl;血清肌酐较基线升高至1.5倍,且该变化发生在前7天内(已知或推测);或者尿量<0.5 mL/kg/小时,持续6小时。我们利用Navicat Premium(版本16)中的SQL编程工具从MIMIC-IV数据库中提取临床数据,数据收集过程遵循了Deshmukh等[9]的既定程序。
该研究收集的变量特征包括年龄、性别、体重和身高。合并疾病包括高血压、糖尿病、充血性心力衰竭、冠心病、急性心肌梗死、脑血管疾病、慢性肺部疾病、慢性肝病、恶性肿瘤。我们收集诊断AKI24小时心率、收缩压、舒张压、 呼吸频率、体温和SpO2、中心静脉压、白细胞、红细胞分布宽度、中性粒细胞计数、血清氯、血清钠、 血清钾、乳酸脱氢酶、动脉血乳酸、PCO2、碳酸氢盐、阴离子间隙、血清纤 维蛋白原、凝血酶原时间、活化部分凝血酶时间、D-二聚体、尿酸、 肌酸激酶、肌酸激酶同工酶、BNP 和血糖、尿比重、丙氨酸转氨酶、碱性磷酸酶、天冬氨酸转氨酶、总胆红素的最大值,患者住 ICU 期间最大的肌酐值及最大的AKI分期。选择红细胞、红细胞压积、血红蛋白、血小板、淋巴细胞计数、 血清钙、PH、PO2、白蛋白在诊断 AKI24 小时内的最小值。治疗包括在 ICU 住院期间是否机械通气和使用血管升压药、CRRT 治疗,是否使用肾毒性药(头孢类抗生素、甘露醇)。我们计算了顺序器官衰竭评估(SOFA)、APACHEII 最大值,斯哥昏迷评分(GCS)的最小值 。存活组和死亡组患者在性别、年龄和实验室检查等一般资料方面比较,差异无统计学意义(P>0.05),具有可比性。
纳入标准(1)年龄≥18 岁,(2)符合肾脏疾病:改善全球结局(KDIGO) AKI 诊断标准, (3) ICU 住院时间超过6 小时, (4) 对于多次住院的患者,仅包括首次住院的 信息。
排除标准为:(1)慢性肾脏病患者。(2)数据严重缺失患者。
1.2 方法
从MIMIC-IV数据库中筛选出28484例首次入住ICU的患者数据,排除了6338例合并慢性肾脏病、27例住院实际时间少于6小时的患者,剔除了患者缺失值超过15%的患者,删除缺失高于20%的特征变量,最终得到3701例可用于分析的患者数据。
采用R语言中的“mice”软件包对剩余数据中的缺失值进行插补。基于收缩压和舒张压计算出平均动脉压、身高和体重计算出体重指数。利用方差膨胀因子(VIF)评估特征之间的共线性。存在高共线性的特征组合包括:身高、体重与体重指数;收缩压、舒张压与平均动脉压;红细胞与血红蛋白,并排除了身高、体重、收缩压、舒张压以及红细胞,其余50个特征用于构建预测模型。
1.3外部验证
MIMICⅢ患者的外部数据集进行外部验证。纳入和排除标准与 MIMICⅣ数据库提取数据相同。
1.4 模型开发和比较
本研究从MIMIC-IV数据库中获取数据,并将其分为两部分:70%的数据用于模型训练,30%的数据用于内部验证。此外,使用独立的外部数据集进行外部验证。研究中运用了10种机器学习模型来预测危重急性肾损伤患者的死亡风险,包括自适应增强、人工神经网络、决策树、额外树、梯度增强机、k近邻、逻辑回归、随机森林、支持向量机和极限梯度增强。
分类变量以频率(百分比)的形式呈现,符合正态分布的连续变量以均值±标准差表示,不符合正态分布的连续变量则以中位数(四分位数范围)表示。为了评估模型的性能,采用受试者工作特征曲线下面积(AUC)、敏感性、特异性、阳性预测值(PPV)、阴性预测值(NPV)、准确性和F1评分衡量模型的可靠性和预测能力。
1.5 特征选择和模型解释
在本研究中,我们通过多轮特征选择流程(包括低方差过滤、高相关性过滤、互信息筛选、SHAP值分析以及递归特征消除)来确定最佳的特征组合。基于Python 3.12版本,我们构建了10种不同的机器学习模型,并对其预测性能进行了评估。SHAP方法解释模型。
1.6 统计学方法
数据分析采用Python 3.12和R 4.3.2。不服从正态分布的连续变量,采用中位数和四分位数间距来描述其分布特征,Mann-Whitney U检验或Kruskal-Wallis H检验进行不同组别间的比较;分类变量则以频数和百分比的形式呈现,统计分析采用卡方检验或费舍尔精确检验。模型的预测性能通过受试者工作特征曲线下面积(AUC)来评估。当双侧P值小于0.05时,认为结果具有统计学显著性。
2 结果
2.1患者特征
在3701 名患者中,中位年龄 65 岁,女性 1532 人(41.3%), 417 名为 AKI 1 期,1529 名为 AKI 2 期,1755 名为 AKI 3 期。合并高血压 1065 人(28.7%),合并糖尿病 935 人(25。2%),死亡 999 人(26.9%)。
2.2 模型开发和性能比较
10 个模型中,随机森林模型(AUC =0.807)对死亡风险的预测效果最好,其次是额外树模型(AUC = 0.803)和梯度增强机模型(AUC = 0.8029)。表现最好的前5个模型的判别性能列于表1。
表1 前 5 个机器学习模型预测性能
机器学习 模型 | AUC | Sensitivity | Specificity | PPV | NPV | accuracy | F1 score |
RF | 0.807 | 0.376 | 0.942 | 0.703 | 0.807 | 0.703 | 0.490 |
ET | 0.803 | 0.339 | 0.786 | 0.699 | 0.858 | 0.699 | 0.457 |
GBM | 0.8029 | 0.403 | 0.929 | 0.672 | 0.929 | 0.672 | 0.504 |
XGboost | 0.771 | 0.380 | 1.000 | 0.592 | 1.000 | 0.592 | 0.531 |
Adaboost | 0.759 | 0.241 | 0.743 | 0.586 | 0.743 | 0.586 | 0.461 |
PPV:阳性预测值,NPV阴性预测值,
2.2最终模型的识别
最终模型根据10个机器学习模型的AUC和预测准确率确定。10种机器学习模型的ROC曲线见图1。
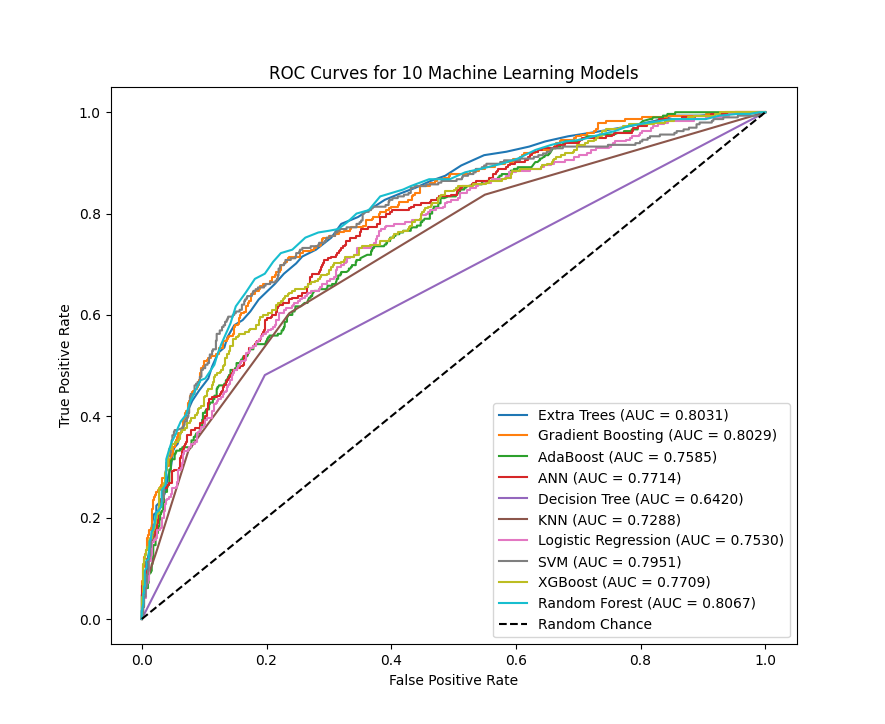
图 1 10种机器学习模型ROC曲线
2.3 最终模型的外部验证
对于外部验证,最终模型的AUC 为 0.720,准确率为0.850,表明最终模型在内部验证和外部验证中都表现出了较好的性能。外部验证ROC曲线见图2。
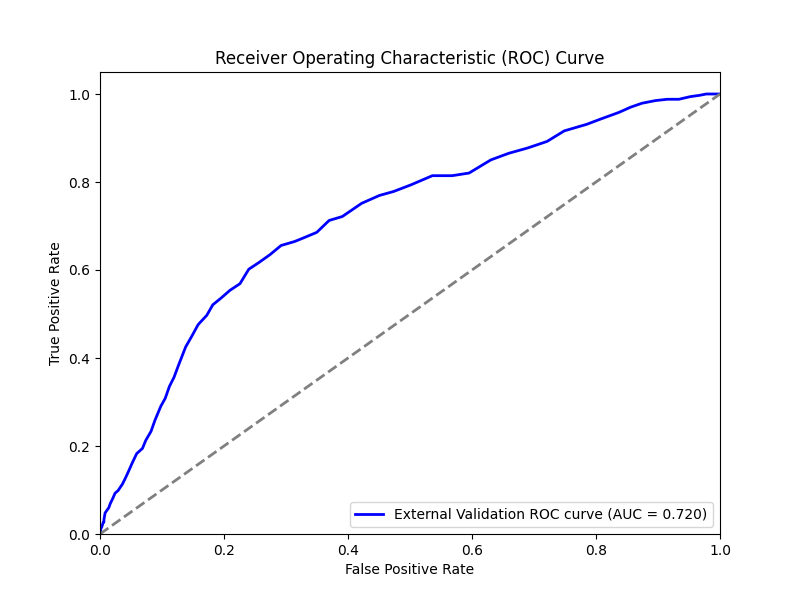
图2 外部验证ROC曲线
2.4 模型的解释
本研究采用SHAP方法解释模型,其提供了模型层面的全局解释和个体层面的局部解释,通过量化每个变量对预测结果的贡献,使模型的解释变得直观易懂。
如图3A所示的SHAP汇总图,通过平均SHAP值来衡量各个特征对模型的贡献程度。此外,SHAP依赖性图能够揭示单个特征如何影响模型的预测输出。例如,图3C展示了12个特征的真实值与对应的SHAP值之间的关系,其中大于零的SHAP值表示该特征对模型的预测产生了正向影响,即提示死亡风险较高。
局部解释专注于分析如何结合特定个体的输入数据来做出预测。以图4为例,根据预测模型,该患者的死亡概率为37%。这种局部解释能够帮助临床医生更好地理解模型是如何针对个体患者做出具体预测的。
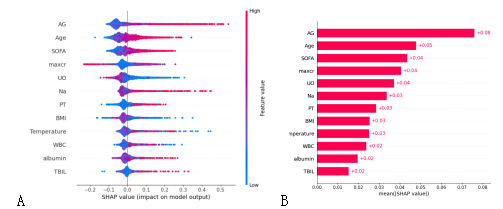
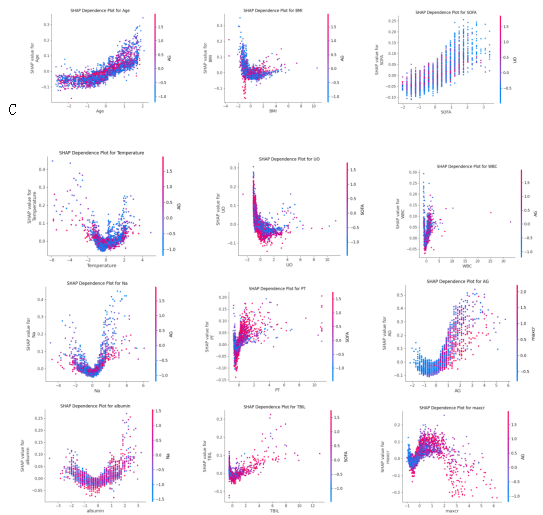
图3(A)RF最佳模型SHAP汇总条形图,(B)RF最佳模型SHAP汇总点阵图,(C)每个依赖关系图显示单个特征如何影响预测模型的输出,每个点表示单个患者。超过零的特定特征的SHAP值将决策推向死亡类。
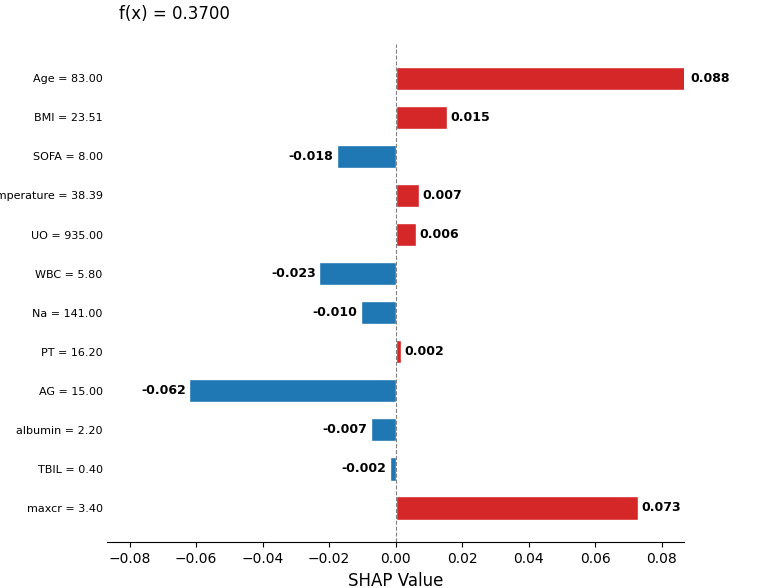
图4 用SHAP方法解释局部模型。左侧为患者特征值,条形图SHAP值为正,说明该特征的促进患者死亡,如果为负,则降低死亡风险。
3.讨论
本研究利用MIMIC数据库,运用10种机器学习方法建立了危重AKI患者死亡风险的预测模型。机器学习方法凭借其处理大数据的能力,能够有效处理高维数据。MIMIC数据库数据量大、质量高,为预测模型的发展提供了有力支持。在本研究中,我们基于随机森林算法构建了一个包含12个特征的最终预测模型。这些特征在ICU入院期间能够轻松获取或评估。在模型中,血清阴离子间隙是影响危重AKI患者死亡风险的最重要因素。已有研究[10]证实,高阴离子间隙(AG)与脓毒症[11]等疾病的严重程度或不良预后呈正相关。此外,年龄也是重症患者死亡率的重要影响因素,随着年龄的增长,重症患者的死亡率显著上升[12]。高钠血症被证明是ICU住院死亡的独立危险因素,而低钠血症可能导致神经系统症状、昏迷甚至死亡[13]。低尿量同样是AKI患者死亡的危险因素,它可能引发高钾血症、代谢性酸中毒和多器官功能衰竭等并发症。凝血酶原时间主要反映凝血因子的合成状态,是评估重症患者凝血功能的重要指标,间接影响患者的预后[14]。为了阐释机器学习模型的“黑箱”问题,我们采用了SHAP解释模型。
然而,本研究也存在一些局限性。首先,模型中缺失了一些重要的特征,例如中心静脉压和心肌酶等。其次,我们在未考虑急性肾损伤病因的情况下建立了AKI死亡风险预测模型。第三,该模型基于美国人群的数据库构建,其在全球人群中的适用性尚不明确,需要进一步评估其泛化能力。第四,ICU住院期间诊断AKI后的24小时数据可能存在选择偏倚。
综上,我们成功开发了一个具有临床应用潜力的预测模型。该模型最终纳入的12个特征在临床实践中易于获取。最终的随机森林模型在内部和外部验证中均表现出良好的预测能力。未来需要开展更多的随机对照研究,以确定基于该预测模型的及时治疗措施是否能够改善重症AKI患者的预后。
参考文献
[1] Chawla LS, Amdur RL, Shaw AD, Faselis C, Palant CE, Kimmel PL. Association between AKI and long-term renal and cardiovascular outcomes in United States veterans. Clin J Am Soc Nephrol 2014;9(3):448–56.
[2] Bouchard J, Soroko SB, Chertow GM, et al. Fluid accumulation, survival and recovery of kidney function in critically ill patients with acute kidney injury. Kidney Int 2009;76(4):422–7.
[3] Coca SG, Yusuf B, Shlipak MG, Garg AX, Parikh CR. Long-term risk of mortality and other adverse outcomes after acute kidney injury: a systematic review and meta-analysis. Am J Kidney Dis 2009;53(6):961–73.
[4] Hoste EA, Bagshaw SM, Bellomo R, et al. Epidemiology of acute kidney injury in critically ill patients: the multinational AKI-EPI study. Intensive Care Med 2015;41(8):1411–23.
[5] Chen V, Li J, Kim JS, et al. Interpretable machine learning: Moving from mythos to diagnostics. 2022:arXiv:2103.06254.
[6] Song X, Liu X, Liu F, et al. Comparison of machine learning and logistic regression models in predicting acute kidney injury: a systematic review and meta-analysis. Int J Med Inform. 2021 ;151:104484. doi: 10.1016/j.ijmedinf.2021.104484.
[7]Yue S, Li S, Huang X, et al. Machine learning for the prediction of acute kidney injury in patients with sepsis. J Transl Med. 2022 ;20(1):215. doi: 10.1186/s12967-022- 03364-0.
[8]Katz S, Suijker J, Hardt C, et al. Decision support system and outcome prediction in a cohort of patients withnecrotizing soft-tissue infections. Int J Med Inform. 2022 ;167:104878.
[9] Deshmukh F, Merchant SS. Explainable Machine Learning Model for Predicting GI Bleed Mortality in the Intensive Care Unit. Am J Gastroenterol 2020;115 (10):1657–68.
[10] Cheng B, Li D, Gong Y, Ying B, Wang B. Serum Anion Gap Predicts All-Cause Mortality in Critically Ill Patients with Acute
Kidney Injury: Analysis of the MIMIC-III Database. Dis Markers.
2020 Jan 21;2020:6501272.
[11] Akinosoglou K, Schinas G, Almyroudi MP, Gogos C, Dimopoulos G. The impact of age on intensive care. Ageing Res Rev. 2023 Feb;84:101832.
[12] 25 N. M. Mohr, J. P. Vakkalanka, B. A. Faine et al., “Serum anion gap predicts lactate poorly, but may be used to identify sepsis patients at risk for death: a cohort study, ” Journal of Critical Care, vol. 44, pp. 223 -228, 2018.
[13]Grim C C A, Termorshuizen F, Bosman R J, et al. Association between an increase in serum sodium and in-hospital mortality in critically ill patients[J]. Critical care medicine, 2021, 49(12): 2070-2079.
[14]Arshad A, Ahmed W, Rehman N, Naseem Z, Ghos Z. Tackling a deadly global phenomenon: sepsis induced coagulopathy: A narrative review. J Pak Med Assoc. 2024 May;74(5):959-966。
相关文献推荐
- 节点文献
- 读者推荐
- 相关基金文献
- 关联作者
- 相关视频
- 批量下載
