
- DOI:
10.13738/j.cnki.acc.qklw60536
- 专辑:
科学Ⅰ辑;信息科技
- 专题:
信息、科学;综合科技
- 分类号:
G90;N92
兰州大学西部生态安全协同创新中心所完成的新冠肺炎疫情全球预测系统,于2020年5月上线运行。系统会实时引入190多个国家的最新数据,综合考虑当地的温度、湿度、防控措施等,逐个建模,预测未来每日、每月、两个季度及突发疫情新增确诊病例,每10天更新一次预测数据,面向全世界免费开放。该系统对北京新发地、黑河爱辉区等地的突发疫情的预测结果表明,该系统至少有92%以上的准确率。那么,该系统的预测机制,又是如何在多因素的干扰条件下,完成病毒传播溯源、传播范围与人数预测以及传播链分析的呢?
这是复杂网络研究领域所关注的问题。这里的复杂网络,不同于我们接触的计算机网络,而是沿用了图论中的许多概念,从网络科学的视角来看问题。实际上,几乎所有的复杂系统(比如社会、生物、信息、技术、交通运输系统)都可以自然地表示为网络。其中,节点代表系统的各种构成要素,节点间的连边表示要之间的联系。最复杂的人类社会系统就可以用一个社会网络刻画,节点是人,人与人之间的各种关系构成社会网络中的链接。社会网络就是复杂网络其中的一种。应用复杂网络的理论和方法能够帮助我们更好地理解这些复杂系统的特征,并对其进行更好地预测和控制.比如完成病毒传播溯源时,应用到的是传播源定位的相关方法;传播范围与人数预测,应用的是复杂网络中的影响力最大化方法。
根据2007年kempe等人的研究,我们将影响力最大化问题定义为:给定一个社会网络图和一种特定的影响力传播模型,在社会网络中找出k(或最少)个节点进行传播,使最终被这k (或最少)个节点影响的节点数目达到最多。这一过程类似于我们在预测病毒传播范围时,通过一名或多名零号病人的人际关系和活动范围,分析最坏的可能性即,在病毒感染概率已知的情况下,最大可能有多少人被感染。感染源可能来自零号病人,也可能来自其密切接触者,或是次密…等等。
这里提到的影响力传播模型,研究中多使用线性阈值模型(LT)、独立级联模型(IC)和传染病模型(SI、SIS、SIR)这几种。
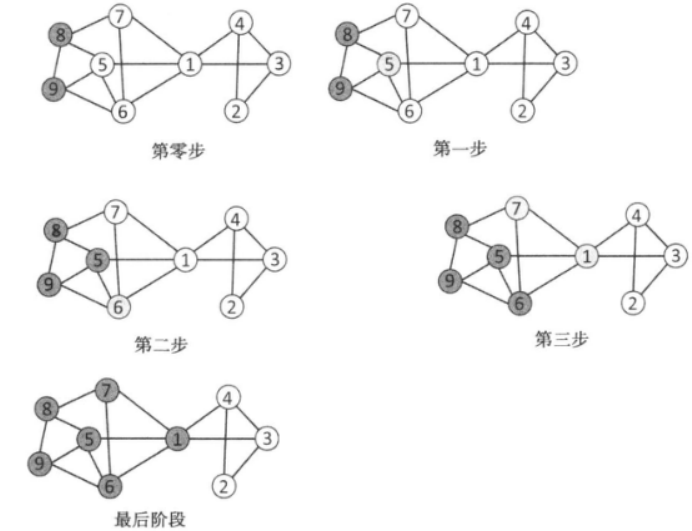
在线性阈值模型(Linear Threshold Model,LT或LTM)中,每个结点V在0~1内均匀分布随机抽取一个阈值v。阈值v表示为了激活结点V,结点V的邻结点需要被激活的比例。假定该网络为有向网,也就是说结点1到2的权值与结点2到1的权值,在线性阈值模型中将起着不同的作用。为简单起见,假定每个结点的阈值,为每对节点间目标结点所连接的活跃结点的度的倒数,每个结点的阈值设为0.5。假设最初的活动结点是结点8和结点9。下图描述了在线性阈值模型条件下信息扩散的过程。在这个过程的第一步,结点5由于其两个邻接结点处于活动状态,并且指向结点5的权值 b8,5 + b9,5= 1/3 +1/3 =2/3,2/3大于阈值0.5,所以结点5被激活。
在第二步中,由于结点6的两个邻接结点5和结点9处于活动状态,因此结点6被激活。从而有结点7和结点1在第三步中被激活。当结点1、5、6、7、8、9被激活后,网络中剩余的其他结点都达不到被激活的条件,因此当结点1、5、6、7、8、9被激活后,信息扩散过程就停止。
独立级联模型(Independent Cascade Model,IC或ICM)借鉴了交互粒子系统和概率论的理念。与线性阈值模型不同,该模型关注信息的发送者(sender)胜过信息的接收者(receiver)。在独立级联模型中,一个结点w一旦在第t步被激活,它有且只有一次机会激活它的邻接结点。对于其邻接结v,其被结点w激活的概率为Pw,v。如果v被成功地激活,那么v就是第t+1步被激活的结点。在往后的信息扩散过程中,w将不再试图去激活它其余的邻接结点。在独立级联模型中,信息扩散过程与线性阈值模型的信息扩散过程相同,都从一个初始活动的结点集合开始,直到没有结点可以被激活而结束。
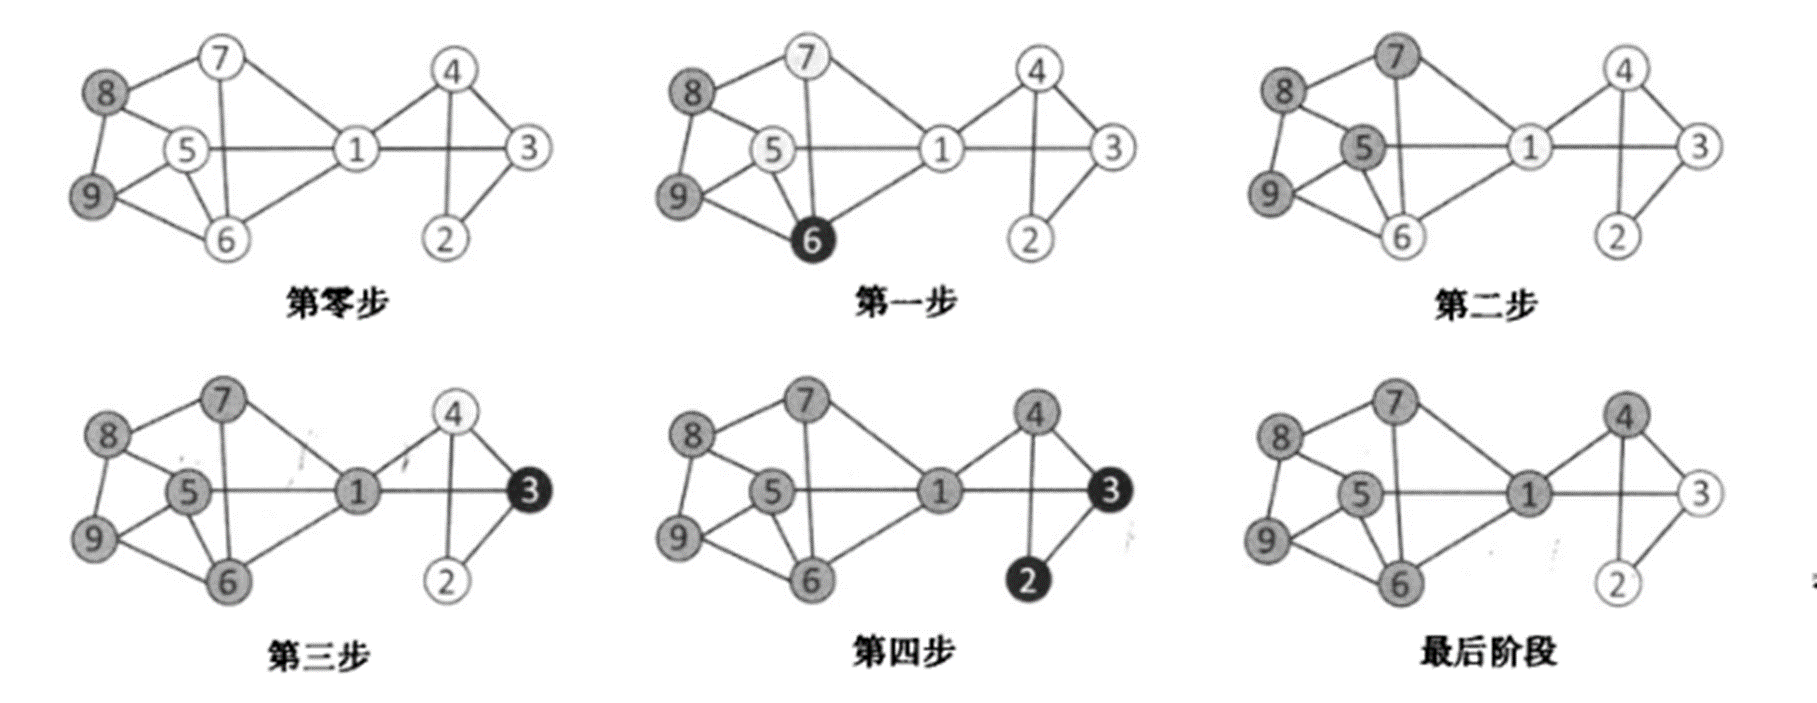
以上图为例:假定网络中的所有结点对间,都有 Pw,v=0.5,也就是说,一个结点一旦被激活,它将以50%的概率激活它的邻接结点。设结点8和结点9为初始活动的结点。从结点8和结点9开始,独立级联模型根据 Pw,v=0.5 的值激活它们的邻接结点。在第一步中,结点8和结点9试图激活它们的邻接结点5、6和7。假设只有结点5 和结点7被成功地激活,结点6的激活失败;给定活动结点5和7,继续按照Pw,v=0.5的概率激活它们邻接结点。第二步中,假设结点1和6被成功激活。由于结点6的所有邻接结点都已被激活,所以在第三步中只要考虑 结点1的邻接结点。按照独立级联模型,结点3 和结点4将以50%的概率被激活。假设只有结点4被成功激活。在第四步中,考虑最近被激活的结点4的邻接结点。假设结点4的邻接结点没有一个被成功激活。那么,网络中信息扩散过程到结点1、4、5、6、7、8、9被激活就终止了。注意,独立级联模型以一定的概率激活一个结点,因此,网络中的结点被激活的顺序并不唯一。遵守独立级联模型的信息扩散过程。深灰色表示结点是活动的,浅灰色表示结点最近被激活,黑色表示结点激活失败
SIR模型是是一种传播模型,是信息传播过程的抽象描述。模型中把传染病流行范围内的人群分成三类:S类,易感者(Susceptible),指未得病者,但缺乏免疫能力,与感病者接触后容易受到感染;I类,感病者(Infective),指染上传染病的人,它可以传播给S类成员;R类,移出者(Removal),指被隔离,或因病愈而具有免疫力的人。SIR模型的建立基于以下三个假设:
⑴不考虑人口的出生、死亡、流动等种群动力因素。人口始终保持一个常数,即N(t)≡K。
⑵一个病人一旦与易感者接触就必然具有一定的传染力。假设 t 时刻单位时间内,一个病人能传染的易感者数目与此环境内易感者总数s(t)成正比,比例系数为β,从而在t时刻单位时间内被所有病人传染的人数为βs(t)i(t)。
⑶ t 时刻,单位时间内从染病者中移出的人数与病人数量成正比,比例系数为γ,单位时间内移出者的数量为γi(t)。
基于以上三个假设条件,感染机制如图中的状态转换方程所示:
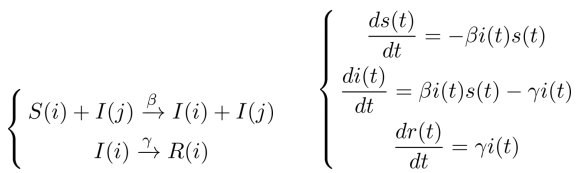
同理,有更适用于某些疾病的SI模型,和更适用于流感病毒传播的SIS模型。SIS模型可以描述如下:最初,所有的节点都处于易感染状态(S),对应个体不知道信息的情况。然后部分节点接触到此信息,变为感染状态(I)。这些节点试着感染处于易感染态的节点,或者恢复为易感状态。
要度量网络中哪k个结点具有最大的传播力量,需要对给出的所有k-结点集,做出其影响能力的量化。因此,kempe等人将影响力,通过特定传播模型量化。首先,对于网络中较大规模的节点数量,这一问题是NP-hard的。其次,传播模型是概率模型,同一组节点,每次传播结束得到的结果可能不尽相同。需要使用mento-carlo模拟过程进行多次试验,取平均值。最后,这种问题解决思想为贪婪算法思想,得到的是问题的近似最优解。
早期研究致力于对贪婪策略进行优化,如CELF算法等,对结点的选取过程,充分利用子模性质,节省大量工作量。随着网络科学研究的热点逐渐从早期发现跨越不同网络的宏观上的普适规律转变为着眼于从中观(社团结构、群组结构)和微观层面(节点、链路)去解释不同网络所具有的不同特征,影响力最大化的研究也开始关注网络的结构本身。这里的网络结构包括度分布、平均距离、连通性、聚类系数、度相关性等方面。在进行复杂网络的社团检测研究时,我们注意到某些网络是带有着明细的社团结构的,这些社团结构可以帮助我们减少影响力最大化研究的工作量,因为社团内部存在着大量的同质结点,其影响力是有着重叠的情况的。因此,研究方向逐渐考虑使用在有明显社团结构的网络中,利用社团结构特点来直接(通过节点在社团中的特点直接找到社团中最重要的节点)或间接(通过贪婪算法)获取k(或最少)个影响力最大化的节点。不使用贪婪算法时,把网络中节点的影响力作为社团划分的标准,并且在社团划分的同时能找到最“重要”的节点作为种子节点。使用贪婪算法时,在社团划分方法选择上,不一定是时间复杂度最低的,而是划分社团质量最好,最“nature”的。候选节点选择:选择数目,选择度量标准很关键。(能够确定一个检验社团在影响力方面重要性的标准supernode)。贪婪算法:已有贪婪或创新。基于社团结构的节点重要性指标:结合社团,结合节点局部特征和全局特征。
自2013年起,有关在线影响力最大化问题的研究开始进入人们的视野。在线影响力最大化算法不依靠假定已知的激活概率,因为现实社交网络中,我们很难得到影响力最大化问题的网络激活概率。目前有关在线影响力最大化算法的研究不多,大多基于陈卫的Combinatorial multi-armed bandit方法在做拓展和优化。受到疫情原因的启发,我们考虑一种类似传染病SIR模型的另一种传播模型,将感染者(I)细化为潜伏态感染者与发病期感染者,进行在线影响力最大化的研究。
相关文献推荐
- 节点文献
- 读者推荐
- 相关基金文献
- 关联作者
- 相关视频
- 批量下載
